Docker Swarm es el modo de clúster que viene integrado en el propio motor de Docker: une varios servidores en uno solo, reparte los contenedores entre ellos y los vuelve a levantar en otro nodo si uno cae. Esta guía muestra cómo montar un clúster de tres nodos, desplegar una aplicación real con réplicas, actualizarla sin cortar el servicio y mantener el clúster. Cierra con los comandos avanzados de Docker que se usan en el diagnóstico diario y con las buenas prácticas que conviene aplicar antes de llevar contenedores a producción.
Si su duda es si necesita un clúster, empiece por la comparación con Kubernetes. En cambio, si ya lo tiene decidido, vaya al despliegue del stack y a la tabla de comandos avanzados.
Dónde encaja esta guía
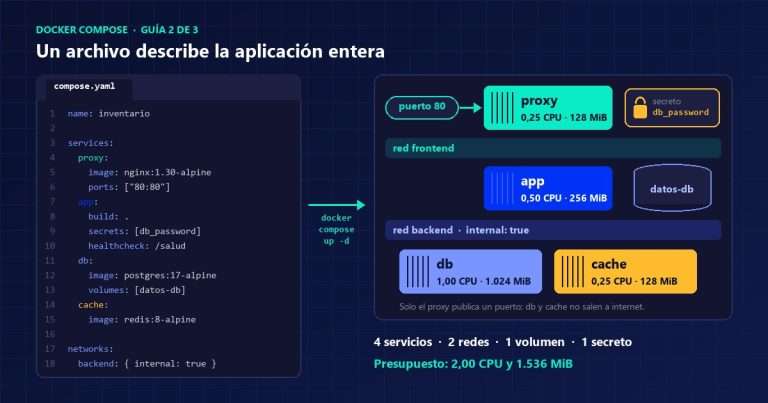
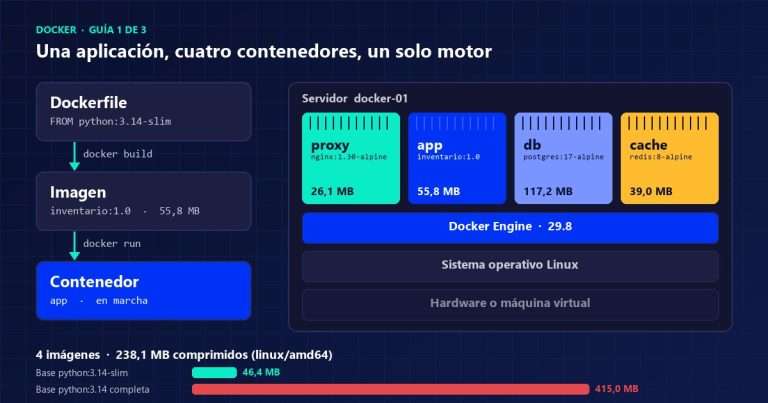
Es la tercera y última guía construida sobre la misma aplicación, el servicio interno inventario. En la primera se midieron sus imágenes: 238,1 MB comprimidos. Después, la segunda la describió en un archivo y calculó su presupuesto: 2 CPU y 1.536 MiB. Aquí ese archivo se despliega en tres servidores, con réplicas, y las cifras cambian de escala.
- Docker — qué es, instalación, primer despliegue y comandos esenciales.
- Docker Compose — la aplicación completa en un archivo, con redes, volúmenes y secretos.
- Docker Swarm — está leyéndola: el clúster de tres nodos, los comandos avanzados y las buenas prácticas.
Qué es Docker Swarm y cuándo tiene sentido
Compose gobierna un servidor, así que cuando ese servidor se apaga, la aplicación se apaga con él. Swarm da el paso siguiente: varios servidores con Docker se agrupan en un clúster, y en lugar de contenedores sueltos se declaran servicios con un número de réplicas. El clúster se encarga de que ese número se cumpla siempre, aunque falle un nodo o se reinicie un contenedor.
No hay que instalar nada aparte: el modo swarm forma parte de Docker Engine desde hace años y se activa con una orden. Además, entiende el mismo formato de archivo que Compose, con una sección deploy para las réplicas y las actualizaciones. Por eso es el camino natural para quien ya trabaja con Compose y necesita tolerancia a fallos sin montar una plataforma nueva.
Sobre su futuro, un dato útil para decidir: Mirantis, que mantiene el proyecto, anunció en julio de 2025 soporte para Swarm hasta al menos 2030 dentro de su plataforma empresarial.
Docker Swarm o Kubernetes
En realidad, es la pregunta que aparece en cuanto se habla de clústeres. La respuesta honesta depende del tamaño del problema y, sobre todo, del equipo que lo va a operar.
| Criterio | Docker Swarm | Kubernetes |
|---|---|---|
| Instalación | Viene en el motor: docker swarm init | Una distribución aparte o un servicio gestionado en la nube |
| Formato | El mismo archivo de Compose, con deploy | Manifiestos propios: Deployment, Service, Ingress y otros |
| Curva de aprendizaje | Días, si ya se usa Compose | Semanas o meses |
| Almacenamiento con estado | Limitado: volúmenes locales o complementos | Maduro, con volúmenes persistentes y controladores de almacenamiento |
| Ecosistema | Reducido | Muy amplio |
| Candidato natural | Pocas aplicaciones y un equipo pequeño | Muchas aplicaciones y un equipo dedicado a la plataforma |
Para una empresa mediana con un puñado de servicios internos, Swarm suele cubrir lo que hace falta con una fracción del trabajo de operación. Kubernetes empieza a compensar cuando hay decenas de aplicaciones y un equipo que se dedica solo a la plataforma.
Arquitectura de un clúster de Docker
Para empezar, un clúster tiene dos papeles. Los managers guardan el estado del clúster y deciden dónde corre cada tarea; los workers solo ejecutan contenedores. Además, un manager también puede ejecutar contenedores, y en clústeres pequeños es lo habitual.
Los managers se ponen de acuerdo con el algoritmo Raft, que exige mayoría para tomar cualquier decisión. De ahí sale la regla más importante del diseño, recogida en la guía de administración: el número de managers debe ser impar.
| Managers | Mayoría necesaria | Caídas que tolera |
|---|---|---|
| 1 | 1 | 0 |
| 3 | 2 | 1 |
| 5 | 3 | 2 |
| 7 | 4 | 3 |
Por ejemplo, cuatro managers toleran lo mismo que tres, una caída, así que el cuarto no aporta nada. Por otro lado, si se pierde la mayoría, los contenedores siguen corriendo, pero el clúster deja de aceptar cambios: no se puede desplegar, escalar ni recuperar tareas caídas hasta restablecerla.
Los puertos que hay que abrir entre nodos
| Puerto | Protocolo | Para qué |
|---|---|---|
| 2377 | TCP | Comunicación con los managers y entre ellos |
| 7946 | TCP y UDP | Descubrimiento de nodos de las redes overlay |
| 4789 | UDP | Tráfico de las redes overlay (VXLAN) |
| Protocolo IP 50 | ESP | Solo si las redes overlay van cifradas |
Sin embargo, el puerto 4789 merece un aviso explícito. VXLAN no autentica, así que la documentación pide abrirlo solo en una red de confianza y nunca en el firewall perimetral. Por eso lo sensato es que los nodos del clúster compartan una VLAN propia, como las que se diseñan en la guía del firewall de Proxmox.
Crear el clúster de Docker Swarm paso a paso
El clúster de la serie son tres máquinas virtuales con Docker Engine instalado como en la primera guía: docker-01, docker-02 y docker-03, cada una con 2 vCPU y 4 GiB. Es decir, 6 vCPU y 12 GiB en total. Pueden vivir en un clúster de virtualización como el de la guía de Proxmox, siempre que cada una quede en un servidor físico distinto: tres nodos de Swarm sobre el mismo anfitrión caen juntos.
# En docker-01: crear el clúster
docker swarm init --advertise-addr 192.168.20.11

# Obtener la orden de unión como manager
docker swarm join-token manager

# En docker-02 y docker-03: pegar esa orden
docker swarm join --token SWMTKN-1-xxxx 192.168.20.11:2377

# De vuelta en cualquier manager
docker node ls
docker node update --label-add datos=si docker-01
Los tres nodos entran como managers, así que el clúster tolera la caída de uno y cualquiera de ellos puede administrarlo. Por otro lado, la etiqueta datos=si marca el nodo donde vivirá la base de datos; su motivo se explica más abajo. Por último, el token de unión es una credencial: quien lo tenga puede meter un nodo en el clúster. Si se filtra, se rota con docker swarm join-token --rotate manager.
Del archivo de Compose al stack de Docker Swarm
En el clúster, una aplicación de varios servicios se llama stack, y se despliega con el mismo formato de archivo de la segunda guía. Sin embargo, cambian cuatro cosas, y conviene conocerlas antes de copiar un archivo que funcionaba en un solo servidor.
- No se construye. La clave
buildse ignora, porque cada nodo descarga la imagen por su cuenta. La imagen de la aplicación tiene que estar en un registro: Docker Hub privado, Azure Container Registry o uno propio. - No hay orden de arranque.
depends_onno tiene efecto, así que cada servicio debe tolerar que los demás aún no estén listos y reintentar. - Los archivos se reparten. Un archivo del disco local no existe en los otros nodos. La configuración de nginx pasa a ser un
configdel clúster. - El reinicio lo gobierna
deploy. La política de reinicio y las actualizaciones se declaran enrestart_policyyupdate_config.
A continuación, el archivo del stack, validado con docker stack config. Como se ve, los cuatro servicios son los mismos, con los mismos límites de recursos.
# inventario-stack.yaml
services:
  proxy:
    image: nginx:1.30-alpine
    ports:
      - "80:80"
    configs:
      - source: nginx_conf
        target: /etc/nginx/conf.d/default.conf
    networks: [frontend]
    deploy:
      replicas: 2
      resources:
        limits: { cpus: "0.25", memory: 128M }
      update_config: { parallelism: 1, delay: 10s }

  app:
    image: registro.ejemplo.local/inventario:${APP_VERSION:-1.0}
    environment:
      DB_HOST: db
      DB_NAME: inventario
      DB_USER: inventario
      DB_PASSWORD_FILE: /run/secrets/db_password
      REDIS_URL: redis://cache:6379/0
    secrets: [db_password]
    healthcheck:
      test: ["CMD", "python", "-c", "import urllib.request; urllib.request.urlopen('http://127.0.0.1:8000/salud')"]
      interval: 15s
      timeout: 3s
      retries: 3
      start_period: 10s
    networks: [frontend, backend]
    deploy:
      replicas: 3
      resources:
        limits: { cpus: "0.50", memory: 256M }
        reservations: { cpus: "0.25", memory: 128M }
      update_config:
        parallelism: 1
        delay: 10s
        order: start-first
        monitor: 30s
        failure_action: rollback
      rollback_config:
        parallelism: 1
      restart_policy:
        condition: on-failure
        max_attempts: 3

  db:
    image: postgres:17-alpine
    environment:
      POSTGRES_DB: inventario
      POSTGRES_USER: inventario
      POSTGRES_PASSWORD_FILE: /run/secrets/db_password
    secrets: [db_password]
    volumes:
      - datos-db:/var/lib/postgresql/data
    healthcheck:
      test: ["CMD-SHELL", "pg_isready -U inventario -d inventario"]
      interval: 10s
      timeout: 3s
      retries: 5
    networks: [backend]
    deploy:
      placement:
        constraints: [node.labels.datos == si]
      resources:
        limits: { cpus: "1.00", memory: 1024M }

  cache:
    image: redis:8-alpine
    command: ["redis-server", "--maxmemory", "96mb", "--maxmemory-policy", "allkeys-lru"]
    networks: [backend]
    deploy:
      resources:
        limits: { cpus: "0.25", memory: 128M }

networks:
  frontend:
    driver: overlay
  backend:
    driver: overlay
    internal: true

volumes:
  datos-db:

configs:
  nginx_conf:
    file: ./nginx.conf

secrets:
  db_password:
    file: ./secretos/db_password.txt
Publicar la imagen y desplegar el stack
# Subir la imagen de la aplicación al registro
docker tag inventario:1.0 registro.ejemplo.local/inventario:1.0
docker push registro.ejemplo.local/inventario:1.0

# Desplegar, pasando las credenciales del registro a los nodos
export APP_VERSION=1.0
docker stack deploy -c inventario-stack.yaml --with-registry-auth inventario

# Comprobar
docker stack services inventario
docker stack ps inventario
Ahora bien, ojo con la variable. A diferencia de Compose, docker stack deploy no lee el archivo .env: si no se exporta en la consola, la sustitución usa el valor por defecto sin avisar. Es un comportamiento conocido desde hace años, recogido en el registro de incidencias del proyecto, y la causa de muchos despliegues que «no cogieron la versión nueva».
Además, los secretos cambian de naturaleza en el clúster. Se guardan cifrados en el registro Raft de los managers, se entregan solo a los nodos que ejecutan un servicio que los declara y se montan en memoria, en /run/secrets/, sin tocar nunca el disco del nodo.
Lo que ocupa el stack en el clúster de Docker Swarm
Con las réplicas, el presupuesto de la segunda guía se multiplica. Es decir, son los mismos límites por contenedor, pero ahora hay siete contenedores en lugar de cuatro.
| Servicio | Réplicas | CPU por réplica | Memoria por réplica | CPU total | Memoria total |
|---|---|---|---|---|---|
| proxy | 2 | 0,25 | 128 MiB | 0,50 | 256 MiB |
| app | 3 | 0,50 | 256 MiB | 1,50 | 768 MiB |
| db | 1 | 1,00 | 1.024 MiB | 1,00 | 1.024 MiB |
| cache | 1 | 0,25 | 128 MiB | 0,25 | 128 MiB |
| Total | 7 tareas | 3,25 de 6 | 2.176 de 12.288 MiB |
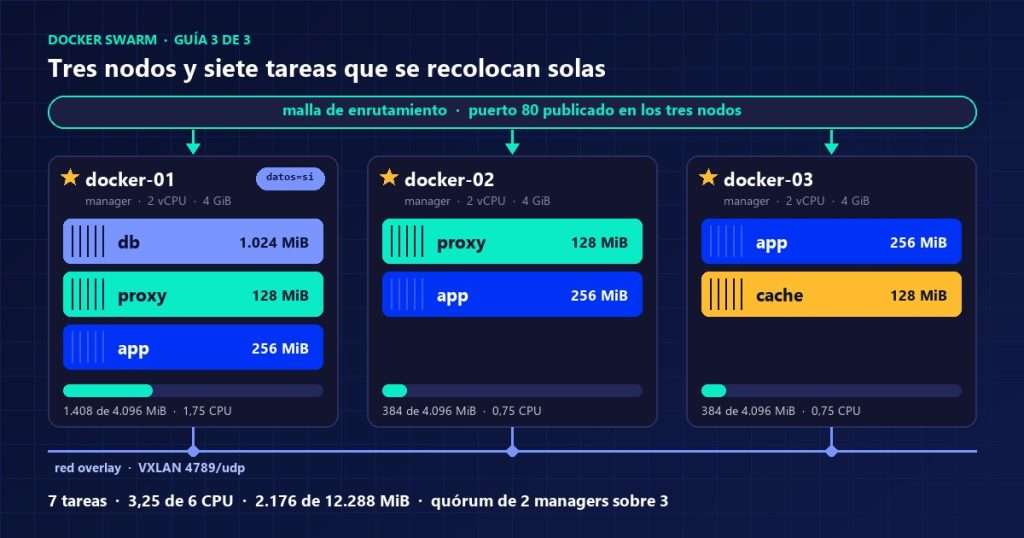
En consecuencia, los límites comprometen el 54 % de la CPU del clúster y el 18 % de su memoria. Así se ve un reparto posible de las siete tareas, con la base de datos fijada en docker-01 por su etiqueta:
| Nodo | Tareas | CPU | Memoria | Descarga de imágenes |
|---|---|---|---|---|
| docker-01 | db, proxy, app | 1,75 | 1.408 MiB | 117,2 + 26,1 + 55,8 = 199,1 MB |
| docker-02 | proxy, app | 0,75 | 384 MiB | 26,1 + 55,8 = 81,9 MB |
| docker-03 | app, cache | 0,75 | 384 MiB | 55,8 + 39,0 = 94,8 MB |
| Clúster | 7 | 3,25 | 2.176 MiB | 375,8 MB |
Además, la última columna recupera un dato de la primera guía. Cada nodo descarga las imágenes de lo que ejecuta, así que el clúster baja 375,8 MB aunque las imágenes distintas sumen 238,1 MB. Por otra parte, la imagen de la aplicación está en los tres nodos. Si se hubiera construido sobre python:3.14 en lugar de la variante slim, cada nodo bajaría 368,6 MB más: 1.105,8 MB de más en cada despliegue, por el mismo programa.
Qué pasa si cae un nodo
Si cae docker-02 o docker-03, sus tareas se recrean en los nodos que quedan, en segundos y sin intervención. Caben de sobra, ya que son como mucho 384 MiB. Además, los dos managers restantes siguen formando mayoría, así que el clúster sigue aceptando órdenes.
En cambio, si cae docker-01, el proxy y la aplicación se recolocan igual, pero la base de datos no. Esto ocurre porque su volumen es local a ese nodo, y la restricción de ubicación impide levantarla en otro lugar con un disco vacío, que sería peor. Esta es, en definitiva, la lección más importante de Swarm: las réplicas protegen a los servicios sin estado, no a los datos. Para la base de datos hay tres salidas razonables:
- Sacarla del clúster a una máquina virtual protegida por la alta disponibilidad de la plataforma de virtualización. Es la opción más sencilla y la que suele convenir a una pyme.
- Almacenamiento compartido mediante un complemento de volúmenes, para que la base de datos pueda arrancar en cualquier nodo.
- Aceptar la parada y tener copias probadas, con un tiempo de recuperación conocido y asumido por la dirección.
Actualizaciones sin corte en Docker Swarm
En este punto aparece la ventaja que Compose no puede dar. Con tres réplicas y order: start-first, el clúster arranca una réplica nueva, espera a que su prueba de salud responda y solo entonces retira una antigua. Después espera diez segundos y repite con la siguiente. Por lo tanto, en ningún momento hay menos de tres réplicas sanas atendiendo.
# Nueva versión: subir la imagen y actualizar solo ese servicio
docker push registro.ejemplo.local/inventario:1.1
docker service update --image registro.ejemplo.local/inventario:1.1 inventario_app

# Seguir el avance, réplica a réplica
docker service ps inventario_app

# Volver a la versión anterior a mano, si hiciera falta
docker service rollback inventario_app
Con failure_action: rollback y monitor: 30s, la vuelta atrás ocurre sola: si una réplica nueva falla durante sus primeros 30 segundos, el clúster detiene la actualización y restaura la versión anterior en todas. Sin monitor, que vale cero por defecto, un fallo que aparece a los diez segundos de arrancar no se detectaría como fallo de la actualización.
Mantenimiento de un clúster de Docker Swarm
En la práctica, tres operaciones cubren casi toda la vida de un clúster: vaciar un nodo para trabajar en él, repartir la carga cuando vuelve y respaldar el estado de los managers.
# Vaciar un nodo antes de parchearlo o reiniciarlo
docker node update --availability drain docker-02
# ... mantenimiento ...
docker node update --availability active docker-02

# Swarm no reequilibra solo al volver: forzar un nuevo reparto
docker service update --force inventario_app

# Respaldo del estado del clúster, en un manager
sudo systemctl stop docker
sudo tar czf swarm-$(hostname)-$(date +%F).tar.gz -C /var/lib/docker swarm
sudo systemctl start docker
Por cierto, el segundo comando responde a una duda frecuente. Cuando un nodo vuelve tras un mantenimiento, Swarm no le devuelve tareas por sí mismo: las deja donde las recolocó. Por eso, forzar la actualización del servicio las redistribuye. Por otro lado, la copia de /var/lib/docker/swarm contiene el estado y las claves de cifrado del clúster; sin ellas no se puede restaurar. Conviene hacerla en un manager y tratarla como un secreto.
Por último, si alguna vez se pierde la mayoría de managers sin remedio, la salida es docker swarm init --force-new-cluster en el manager que sobrevive. Esa orden lo convierte en un clúster de un solo manager con el estado que tenía, y después se vuelven a unir los demás nodos.
Comandos avanzados de Docker
A partir de aquí, estos comandos sirven igual en un servidor con Compose que en el clúster. Son los que separan buscar a ojo en una pantalla llena de texto de obtener exactamente el dato que hace falta.
Filtrar y dar formato a la salida
Para empezar, casi todos los comandos de listado aceptan --filter para elegir filas y --format para elegir columnas con plantillas de Go. Con ellos, la salida pasa de ser algo que se lee a algo que se puede procesar.
# Tabla a medida
docker ps --format 'table {{.Names}}\t{{.Status}}\t{{.Ports}}'

# Solo los contenedores que no están sanos
docker ps --filter health=unhealthy

# Un dato concreto de un objeto
docker inspect -f '{{.State.Health.Status}}' inventario-app-1
docker inspect -f '{{range .NetworkSettings.Networks}}{{.IPAddress}} {{end}}' inventario-app-1

# Todo el objeto en JSON, para procesarlo con jq
docker inspect inventario_app | jq '.[0].Spec.TaskTemplate.Resources'
Diagnóstico: registros, eventos y consumo
# Solo lo reciente, sin leer un registro de semanas
docker logs --since 30m --tail 200 inventario-app-1
docker service logs -f --since 10m inventario_app

# Qué contenedores murieron en la última hora
docker events --since 1h --filter type=container --filter event=die

# Consumo en una sola lectura, sin quedarse en pantalla
docker stats --no-stream --format 'table {{.Name}}\t{{.CPUPerc}}\t{{.MemUsage}}'

# Por qué una réplica no arranca: el error completo
docker service ps --no-trunc inventario_app
De hecho, el último comando resuelve buena parte de las consultas de un clúster. Cuando una tarea no arranca, la columna de error explica el motivo exacto: imagen inexistente, credenciales del registro, restricción de ubicación imposible o falta de memoria reservable.
Limpieza con criterio
# Qué ocupa cada cosa, con detalle
docker system df -v

# Imágenes sin usar de más de 30 días
docker image prune -a --filter "until=720h"

# Caché de construcción de más de una semana
docker builder prune --filter "until=168h"
El filtro until es la diferencia entre limpiar y arrasar. Además, conserva lo reciente, que es justo lo que haría falta para volver a la versión anterior.
Administrar varios servidores desde un equipo
Por su parte, los contextos guardan la conexión a otros motores. Con ellos, el mismo cliente administra el portátil, un servidor remoto por SSH o el clúster, sin abrir sesiones.
docker context create docker-01 --docker "host=ssh://admin@docker-01"
docker context create docker-02 --docker "host=ssh://admin@docker-02"
docker context create docker-03 --docker "host=ssh://admin@docker-03"

docker --context docker-01 node ls
docker context use docker-01
Imágenes para Intel y ARM a la vez
Si el clúster mezcla procesadores, la imagen propia tiene que existir para ambas arquitecturas, igual que las oficiales. buildx construye las dos variantes y las publica bajo la misma etiqueta. Después, cada nodo descarga la suya, como se explica en la guía de AMD64 vs ARM64.
docker buildx build --platform linux/amd64,linux/arm64 \
  -t registro.ejemplo.local/inventario:1.1 --push .
Del clúster a un informe
Sin embargo, docker stats solo ve los contenedores del motor al que se conecta. Con los contextos, una sola línea recorre los tres nodos y deja el consumo en un CSV, con el nodo como primera columna.
for n in docker-01 docker-02 docker-03; do
  docker --context $n stats --no-stream \
    --format "$n;{{.Name}};{{.CPUPerc}};{{.MemUsage}};{{.MemPerc}}"
done > consumo-$(date +%F).csv

docker service ls --format '{{.Name}};{{.Replicas}};{{.Image}}' > servicios-$(date +%F).csv
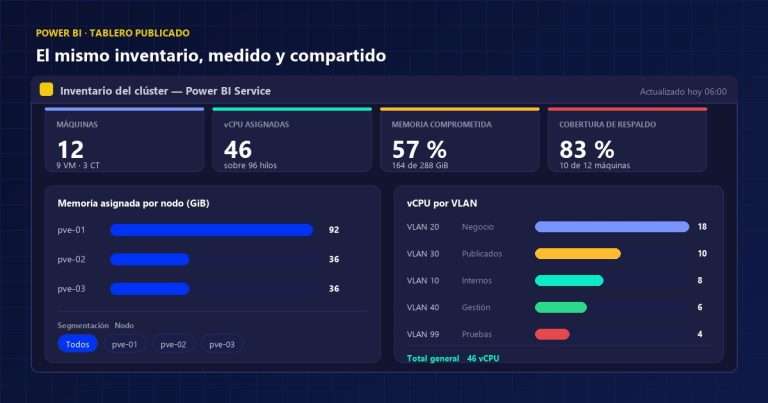
Así, ese archivo es un origen de datos como cualquier otro. Con Power Query se limpia y se acumula mes a mes, y con Power BI se convierte en un tablero de capacidad: memoria comprometida por nodo, réplicas por servicio y la evolución del consumo real frente a los límites. Es la misma idea que cierra la serie de Proxmox, aplicada a contenedores.
Buenas prácticas para Docker en producción
Por último, esta es la lista de comprobación que resume las tres guías. Ninguna práctica cuesta dinero; todas evitan un incidente concreto.
| Práctica | Qué evita | Cómo |
|---|---|---|
| Fijar versiones | Actualizaciones sorpresa con latest | nginx:1.30-alpine, nunca nginx a secas |
| Imágenes base pequeñas | Descargas lentas y más componentes vulnerables | Variantes slim o alpine |
| Usuario sin privilegios | Que una intrusión en la aplicación sea root en el contenedor | USER en el Dockerfile |
| Límites de recursos | Que un servicio agote el servidor entero | deploy.resources.limits |
| Pruebas de salud | Contenedores «arrancados» que no responden | healthcheck real, no un proceso vivo |
| Secretos, no variables | Contraseñas visibles con docker inspect | secrets y variables con sufijo _FILE |
| Registros que rotan | Discos llenos por la salida de los contenedores | Controlador local en daemon.json |
| Puertos solo donde hace falta | Servicios expuestos que ufw no filtra | Un único proxy publicado y redes internas |
| No exponer el socket | Control total del anfitrión desde un contenedor | No montar /var/run/docker.sock salvo en herramientas de confianza |
| Imágenes de origen fiable | Software malicioso camuflado | Oficiales o de editores verificados |
| Copias fuera del servidor | Perder los datos con el disco | Volcado de la base de datos y copia externa |
| Monitoreo | Enterarse de la caída por los usuarios | Salud, consumo y disponibilidad vigilados |
Además, tres de ellas enlazan con otras guías del blog. El riesgo de las imágenes de origen dudoso tiene precedente real: en 2022 apareció código malicioso en más de mil imágenes públicas. Las copias siguen el mismo criterio que la guía del respaldo inmutable. Y el monitoreo de un clúster es el de cualquier servidor, con las métricas que describe la guía de monitoreo de servidores.
Una práctica más, propia de la versión 29 del motor: la función Docker Content Trust desapareció del cliente. Quien firmaba imágenes con ella tiene que revisar su procedimiento antes de actualizar.
Preguntas frecuentes sobre Docker Swarm
¿Se puede empezar con un solo nodo?
Sí, y es una buena forma de aprender: docker swarm init en un servidor ya permite desplegar stacks, secretos y actualizaciones progresivas. Lo que no hay es tolerancia a fallos, que exige al menos tres managers. Por eso un clúster de dos nodos es la peor opción: si cae uno, se pierde la mayoría.
¿Existe una interfaz gráfica para Swarm?
El proyecto no trae una; sin embargo, existen herramientas web de terceros, como Portainer, que muestran nodos, servicios y registros. Son cómodas para consultar. Aun así, conviene que los cambios sigan entrando por el archivo del stack, para que quede constancia de cada uno.
¿Cuándo pasar de Swarm a Kubernetes?
Cuando el número de aplicaciones, de equipos o de requisitos de almacenamiento con estado supere lo que Swarm resuelve con sencillez. El archivo de Compose no se tira: es la mejor especificación de partida para escribir los manifiestos de Kubernetes.
Qué llevarse sobre Docker Swarm
Docker Swarm convierte el archivo de Compose en un servicio que sobrevive a la caída de un servidor, con el mismo formato y sin instalar nada aparte. La aplicación de la serie pasa de 4 contenedores a 7 tareas, de 1.536 a 2.176 MiB y de un servidor a tres, con actualizaciones sin corte y vuelta atrás automática. Su límite también quedó claro: las réplicas protegen a los servicios sin estado, y la base de datos necesita su propia estrategia.
En resumen, con esta guía se cierra la serie. Una imagen construida con cuidado en la primera, descrita en un archivo en la segunda y repartida en un clúster en la tercera. Si su empresa quiere los beneficios sin cargar con la operación, en KHARONTE administramos esa capa dentro del servicio de infraestructura de TI, y vigilamos su salud y su capacidad con el de monitoreo y operación.