La alta disponibilidad es el conjunto de decisiones de diseño que hacen que un servicio siga funcionando aunque una de sus piezas falle. No es un producto que se compra ni una casilla que se activa: es una propiedad que se construye eliminando, una por una, las piezas de las que todo depende. Esta guía explica qué es la alta disponibilidad, cómo se mide, en qué se diferencia del respaldo y cómo se diseña sin gastar de más.
Está escrita en dos niveles. Si usted dirige una empresa y no es de sistemas, encontrará qué significan los famosos «nueves», cuánto tiempo de caída admite cada uno y qué preguntas conviene hacerle a su proveedor. Si usted administra la infraestructura, encontrará la parte técnica: clústeres, quórum, conmutación por error, balanceo de carga, réplicas de base de datos y qué dicen realmente los acuerdos de nivel de servicio de la nube.
Qué es la alta disponibilidad y qué problema resuelve
Todo sistema se cae alguna vez. Un disco se rompe, una fuente de poder se quema, un técnico desconecta el cable equivocado, el proveedor de internet pierde la fibra. La pregunta que importa no es si va a ocurrir, sino qué pasa cuando ocurre: si el servicio se detiene hasta que alguien lo repare, o si sigue andando mientras tanto.
Esa segunda respuesta es la alta disponibilidad. En inglés se abrevia HA, de high availability, y su idea es sencilla: por cada pieza de la que dependa el servicio, hay otra lista para asumir su trabajo. Así, cuando la primera falla, la segunda entra sin que el usuario tenga que hacer nada. El objetivo no es evitar los fallos, que es imposible, sino evitar que un fallo se convierta en una caída.
Conviene separarla de dos conceptos que suelen confundirse con ella. La fiabilidad mide con qué frecuencia falla un componente; la tolerancia a fallos es la capacidad de seguir operando pese al fallo, y la alta disponibilidad es el resultado que se busca. Dicho de otro modo, la tolerancia a fallos es el medio y la disponibilidad es la medida. Además, un sistema con alta disponibilidad no está a salvo de un borrado, de un cifrado por secuestro de datos ni de un error humano: para eso existen las copias, que son otra capa distinta.
Cómo se mide la alta disponibilidad: los nueves
La disponibilidad se expresa como un porcentaje de tiempo. Amazon la define de la forma más directa posible en el pilar de fiabilidad de su marco de buena arquitectura: es el tiempo disponible dividido por el tiempo total del periodo que se mida, normalmente un mes o un año.
Disponibilidad = tiempo disponible / tiempo total

Ejemplo: un servicio que estuvo caído 3 horas en un mes de 30 días
43.200 min - 180 min = 43.020 min
43.020 / 43.200 = 0,99583 -> 99,58 %
Qué significa cada nueve en minutos de caída
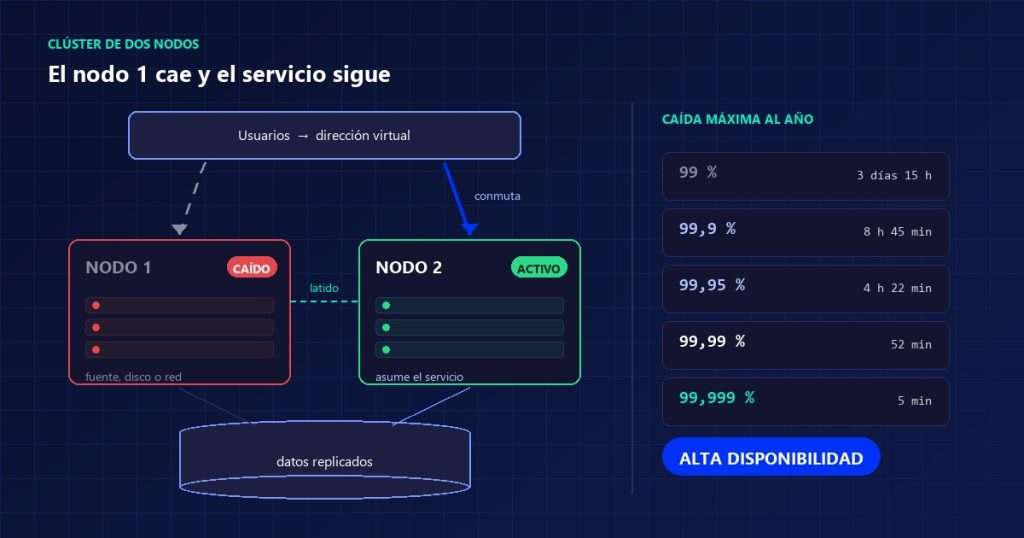
En el sector se habla de «tres nueves» o «cinco nueves» como si fueran categorías. Traducidos a tiempo real, dejan de sonar abstractos. Esta tabla recoge los valores publicados por Amazon para el año, con la columna mensual calculada sobre un mes de treinta días:
| Disponibilidad | Caída máxima al año | Caída máxima al mes | Ejemplo típico |
|---|---|---|---|
| 99 % (dos nueves) | 3 días 15 horas | 7 h 12 min | Procesos por lotes, cargas nocturnas |
| 99,5 % | 1 día 19 h 48 min | 3 h 36 min | Herramientas internas de apoyo |
| 99,9 % (tres nueves) | 8 h 45 min | 43 min 12 s | Correo, gestión documental, intranet |
| 99,95 % | 4 h 22 min | 21 min 36 s | Comercio en línea, punto de venta |
| 99,99 % (cuatro nueves) | 52 min | 4 min 19 s | Facturación electrónica, video |
| 99,999 % (cinco nueves) | 5 min | 26 s | Cajeros, telecomunicaciones |
El salto entre filas es el que decide el presupuesto. Por ejemplo, pasar de 99,9 % a 99,99 % no cuesta un diez por ciento más: además de duplicar la infraestructura, suele exigir automatizar la conmutación y sostener un equipo que la pruebe. Por eso el primer trabajo serio de un proyecto de alta disponibilidad no es técnico, sino de negocio: decidir qué servicios merecen cada nivel.
La fórmula con MTBF y MTTR
Cuando el fabricante no publica un dato de disponibilidad, se puede estimar con dos medidas clásicas: el MTBF, o tiempo medio entre fallos, y el MTTR, el tiempo medio de recuperación. Amazon documenta el cálculo y su ejemplo: con un MTBF de 150 días y un MTTR de una hora, la disponibilidad estimada es del 99,97 %.
Disponibilidad estimada = MTBF / (MTBF + MTTR)

MTBF 150 días = 3.600 h
MTTR 1 h
3.600 / (3.600 + 1) = 0,99972 -> 99,97 %
La lectura práctica de esa fórmula es reveladora. Reducir el MTTR mejora la disponibilidad igual que aumentar el MTBF, y casi siempre es más barato. Un repuesto en sitio, un procedimiento escrito y un monitoreo que avise antes que el usuario bajan el tiempo de recuperación sin comprar un solo servidor más.
Alta disponibilidad, respaldo y recuperación ante desastres
Son tres capas distintas y resuelven problemas distintos. Confundirlas es el error más caro y más frecuente de todos, porque lleva a empresas a pagar un clúster creyendo que con eso ya tienen protegidos los datos.
| Capa | De qué protege | De qué NO protege | Tiempo típico de vuelta |
|---|---|---|---|
| Alta disponibilidad | Fallo de un componente: disco, fuente, servidor, enlace | Borrado, cifrado por secuestro, error humano, corrupción lógica | Segundos o minutos, automático |
| Respaldo | Pérdida o alteración del dato, con vuelta a un punto anterior | Que el servicio siga en pie mientras se restaura | Horas, manual |
| Recuperación ante desastres | Pérdida de una sede o de un centro de datos completo | Un fallo pequeño, que ni siquiera activa el plan | De horas a días, con procedimiento |
Microsoft lo dice sin rodeos en su documentación de grupos de disponibilidad de SQL Server: «las bases de datos secundarias no son copias de seguridad», y recomienda seguir respaldando bases y registros con normalidad. La réplica copia también el error: si alguien borra una tabla en el nodo principal, el secundario la borra un segundo después. Por eso la alta disponibilidad y el respaldo inmutable se suman, nunca se sustituyen.
Los dos relojes que ordenan la conversación
Antes de diseñar nada hay que fijar dos números por cada servicio. El primero es cuánto tiempo puede estar caído; el segundo, cuántos datos se pueden perder medidos en tiempo. Ambos se acuerdan con el área dueña del proceso, no con el área de sistemas, y son los que deciden la arquitectura.
| Servicio | Caída tolerable | Pérdida de datos tolerable | Qué implica |
|---|---|---|---|
| Facturación electrónica | Minutos | Cero | Réplica síncrona y conmutación automática |
| Correo corporativo | 1 a 2 horas | Minutos | Servicio en nube con respaldo propio |
| Archivos compartidos | 4 horas | 1 hora | Copia frecuente y repuesto disponible |
| Intranet o portal interno | 1 día | 1 día | Copia diaria, sin redundancia |
Este ejercicio ahorra dinero de verdad. De hecho, casi siempre revela que dos o tres servicios necesitan alta disponibilidad y el resto no, aunque la conversación hubiera empezado pidiendo redundancia para todo.
Puntos únicos de fallo: dónde se rompe la alta disponibilidad
Un punto único de fallo es cualquier pieza cuya avería detiene el servicio entero. Encontrarlos es el trabajo central del diseño, y la técnica es tan simple como incómoda: recorrer la ruta completa que sigue una petición del usuario y preguntarse, en cada paso, «¿y si esto se apaga ahora?».
| Capa | Punto único frecuente | Cómo se elimina |
|---|---|---|
| Energía | Una sola acometida, un solo UPS | Doble acometida, UPS en paralelo, planta eléctrica |
| Servidor | Una sola fuente de poder, un solo disco | Fuentes redundantes, arreglo de discos, doble tarjeta de red |
| Cómputo | Un servidor que lo corre todo | Clúster de dos o más nodos |
| Red interna | Un único conmutador central | Dos conmutadores apilados y enlaces agregados |
| Salida a internet | Un solo proveedor | Dos proveedores por rutas físicas distintas |
| Nombres | Un único servidor de DNS o de directorio | Dos controladores replicados |
| Datos | Una sola copia de la base | Réplica en otro nodo, más respaldo |
| Personas | Un solo técnico que sabe cómo funciona | Documentación y relevo formado |
La última fila no es un chiste. En muchas empresas medianas el punto único más grave no es un equipo, sino la única persona que conoce la contraseña del hipervisor. Ese riesgo se cubre con documentación y con personal de relevo, no con hardware.
Redundancia en alta disponibilidad: N, N+1 y 2N
La notación viene del mundo del centro de datos y se aplica igual al cómputo, a la energía y a la refrigeración. La letra N representa justo lo que hace falta para sostener la carga; lo que se añade después es el margen.
| Modelo | Qué significa | Qué resiste | Coste relativo |
|---|---|---|---|
| N | La capacidad exacta necesaria | Nada: cualquier fallo es una caída | 1× |
| N+1 | Una unidad de más | El fallo de una unidad, o su mantenimiento | 1,2× a 1,5× |
| 2N | Dos conjuntos completos e independientes | El fallo de un conjunto entero, con su ruta | 2× |
| 2N+1 | Dos conjuntos, y uno de más en cada uno | Fallo durante un mantenimiento programado | Más de 2× |
Hay un matiz que se pasa por alto con frecuencia. N+1 protege del fallo, pero no siempre del mantenimiento: mientras se actualiza la unidad de repuesto, el sistema vuelve a quedar en N. Esa es exactamente la diferencia entre los dos niveles altos de certificación de centro de datos que se explican más abajo. Por lo tanto, la tolerancia a fallos real de un modelo N+1 depende de cuándo se hace el mantenimiento.
Amazon publica además el cálculo de lo que aporta la redundancia. Dos componentes independientes con 99,9 % cada uno dan, en teoría, 99,9999 %: se resta del cien por cien el producto de las dos tasas de fallo. El atajo es cómodo de recordar, y consiste en sumar los nueves de cada componente.
Efectiva = 100 % - ((100 % - 99,9 %) x (100 % - 99,9 %))
         = 100 % - (0,1 % x 0,1 %)
         = 99,9999 %   (tres nueves + tres nueves = seis nueves)
La palabra clave de esa frase es independientes. Dos servidores en el mismo rack, con la misma regleta y el mismo conmutador, no son independientes: comparten tres puntos únicos de fallo y la suma de nueves no se cumple. Esa es la diferencia entre duplicar equipos y diseñar alta disponibilidad.
Qué es un clúster de alta disponibilidad
Un clúster de alta disponibilidad es un grupo de servidores, llamados nodos, que se vigilan entre sí y se reparten un conjunto de servicios. Los nodos intercambian un latido constante por la red. Si el latido de uno se pierde, los demás dan por caído a ese nodo y, en consecuencia, arrancan sus servicios en otro sitio.
El usuario no se conecta a un servidor concreto, sino a un nombre o a una dirección virtual que viaja con el servicio. Cuando el servicio cambia de nodo, la dirección se mueve con él, y la aplicación del usuario apenas nota una reconexión.
Activo-pasivo y activo-activo
| Criterio | Activo-pasivo | Activo-activo |
|---|---|---|
| Cómo trabaja | Un nodo atiende, el otro espera | Los dos atienden a la vez |
| Aprovechamiento | La mitad del hardware está en reserva | Se usa todo el hardware |
| Rendimiento tras el fallo | Igual, porque el repuesto está entero | Menor: la carga de dos cabe en uno |
| Complejidad | Baja | Alta: exige coordinar escrituras |
| Cuándo conviene | Bases de datos, aplicaciones con estado | Servidores web, servicios sin estado |
En activo-activo hay una trampa de capacidad. Si dos nodos trabajan al 70 % cada uno y muere uno, el superviviente recibe el 140 % de lo que puede: el clúster no se cae, pero el servicio se arrastra. Por eso, al dimensionar un clúster de alta disponibilidad en activo-activo, se planifica que cada nodo no pase del 50 % en operación normal.
Quórum, cerebro dividido y aislamiento del nodo
Aquí está el problema difícil de cualquier clúster. Si la red entre dos nodos se corta, cada uno deja de ver al otro y cada uno concluye lo mismo: «el otro murió, asumo el servicio». Los dos arrancan la misma base de datos sobre el mismo disco y la corrompen. Ese escenario se llama cerebro dividido, o split-brain.
La primera defensa es el quórum: solo el grupo que reúne la mayoría de votos tiene derecho a prestar servicio. Por eso los clústeres se montan con un número impar de nodos, o con un testigo que aporta el voto de desempate cuando solo hay dos.
La segunda es el fencing, que la documentación de Pacemaker define como «la capacidad de impedir que un nodo ejecute recursos, incluso cuando no responde a las órdenes del clúster». Su implementación más común corta la energía del nodo sospechoso, y de ahí el acrónimo STONITH. Suena brutal, y lo es a propósito: un nodo apagado no puede corromper nada. El mismo texto añade una condición importante, y es que una partición del clúster solo puede ejecutar el aislamiento si tiene quórum.
Un clúster de alta disponibilidad sin fencing configurado parece funcionar durante meses. Falla el día que se corta el enlace entre nodos, que es precisamente el día para el que se compró.
Failover y failback: cómo conmuta el servicio
El failover, o conmutación por error, es el momento en que el servicio pasa del nodo caído al que sigue en pie. El failback es la vuelta al nodo original cuando se repara. Ninguno de los dos es instantáneo, y entender su reloj evita promesas imposibles: el failover no elimina la interrupción, la acorta.
| Fase | Qué ocurre | Orden de magnitud |
|---|---|---|
| Detección | Se pierden varios latidos seguidos | 5 a 30 segundos |
| Decisión | El clúster comprueba quórum y elige destino | 1 a 5 segundos |
| Aislamiento | Se apaga o se bloquea el nodo sospechoso | 5 a 20 segundos |
| Arranque | Se montan discos y se levantan los servicios | 10 segundos a varios minutos |
| Reconexión | Los clientes reconectan a la dirección virtual | Segundos, si la aplicación reintenta |
Ese último paso depende de la aplicación, no del clúster. Un programa que no reintenta la conexión mostrará un error al usuario aunque la conmutación haya sido perfecta. Microsoft insiste en ese punto cuando explica cómo leer un acuerdo de nivel de servicio: los fallos transitorios son una condición normal, no excepcional, y la arquitectura tiene que tolerarlos con reintentos.
Conviene además decidir si el failback es automático. Volver solo al nodo reparado parece elegante, pero provoca una segunda interrupción en un horario que nadie eligió. En la mayoría de los casos se deja manual y se programa, de modo que el failover sea automático y la vuelta no.
Balanceo de carga: repartir para no depender de uno
El balanceo de carga reparte las peticiones entre varios servidores que hacen lo mismo. Aporta rendimiento, pero sobre todo aporta disponibilidad: si uno de los servidores deja de responder, el balanceador deja de enviarle tráfico y el resto absorbe su parte sin que nadie intervenga. En servicios sin estado, el balanceo de carga es la forma más barata de conseguir alta disponibilidad.
Capa 4 y capa 7
| Criterio | Capa 4 (transporte) | Capa 7 (aplicación) |
|---|---|---|
| Qué mira | Dirección IP y puerto | La petición completa: ruta, encabezados, cookies |
| Puede repartir por | Conexión | Contenido: /api a un grupo, /web a otro |
| Coste de proceso | Bajo, muy rápido | Mayor, pero con más control |
| Cifrado | Pasa de largo | Puede terminarlo y repartir en claro por dentro |
Sondas de salud y sesiones persistentes
Una sonda de salud es la comprobación periódica con la que el balanceador decide si un servidor sigue vivo. El error clásico consiste en sondear solo el puerto. Un servidor puede aceptar conexiones en el 443 con la base de datos caída detrás, y el balanceador le seguirá mandando usuarios a una página de error.
En cambio, la sonda útil llama a una dirección propia de la aplicación que verifica de verdad sus dependencias y responde según el resultado. Gracias a eso, el balanceo de carga retira el servidor enfermo antes de que el usuario lo note.
El otro asunto son las sesiones persistentes. Si la aplicación guarda la sesión en la memoria del servidor, el usuario tiene que volver siempre al mismo, y entonces la caída de ese servidor cierra su sesión. La solución correcta no es forzar la persistencia, sino sacar la sesión del servidor y llevarla a un almacén compartido. Así cualquier nodo puede atender a cualquier usuario, que es de lo que trata la alta disponibilidad.
Alta disponibilidad en la red corporativa
De poco sirve un clúster de alta disponibilidad impecable si el camino hasta él pasa por un solo cable. Por añadidura, la red suele concentrar los puntos únicos más baratos de resolver y, a la vez, los más olvidados, empezando por la puerta de enlace.
VRRP: la puerta de enlace que no se cae
Todos los equipos de una red apuntan a una misma puerta de enlace. El RFC 5798 lo plantea sin medias tintas: la pérdida del enrutador por defecto «es un evento catastrófico que aísla a todos los equipos finales».
El protocolo VRRP resuelve eso haciendo que dos o más enrutadores se presenten como uno solo. Uno actúa de maestro y responde por la dirección virtual; el resto espera de reserva. El maestro anuncia su presencia cada segundo por defecto, y el enrutador dueño de la dirección tiene prioridad 255 frente a la prioridad 100 de los demás. Si el maestro deja de anunciarse, la reserva toma la dirección virtual y los equipos de la oficina ni se enteran.
Enlaces, agregación y doble proveedor
| Riesgo | Medida | Detalle que suele fallar |
|---|---|---|
| Un cable suelto entre conmutadores | Agregación de dos enlaces | Configurarla en un solo extremo no sirve |
| Muere el conmutador de núcleo | Dos conmutadores apilados | Repartir los servidores entre ambos, no dejarlos en uno |
| Se corta la fibra del proveedor | Segundo proveedor | Comprobar que no comparten la misma canalización |
| Cae el enrutador | VRRP entre dos equipos | Probar la conmutación antes de darla por buena |
| Se apaga el rack | Doble acometida y regletas separadas | Conectar las dos fuentes del servidor a regletas distintas |
La última fila es la más repetida de todas. Un servidor con dos fuentes conectado a una única regleta tiene redundancia de fuente y ninguna redundancia de energía. Estos detalles se revisan al diseñar la red corporativa, no después.
Alta disponibilidad en las bases de datos
La base de datos es casi siempre la pieza más difícil, porque tiene estado y no admite dos escritores a la vez. Por ese motivo, el mecanismo estándar es la réplica: el nodo principal envía sus registros de transacción a uno o varios secundarios, que a su vez los aplican sobre su propia copia.
Réplica síncrona y asíncrona
La diferencia decide si se puede perder un dato. En modo síncrono el principal no confirma una transacción hasta que el secundario avisa de que la escribió en disco: no hay pérdida, pero cada operación paga la latencia de ida y vuelta. En modo asíncrono el principal confirma de inmediato y el secundario va detrás, así que el rendimiento es mejor y una caída puede costar las últimas transacciones.
La documentación de grupos de disponibilidad Always On de SQL Server concreta las cifras y las condiciones:
| Aspecto | Lo que documenta Microsoft |
|---|---|
| Réplicas | Una principal y hasta ocho secundarias, nueve en total |
| Réplicas síncronas | Hasta cinco incluida la principal desde SQL Server 2019, frente a tres en 2017 |
| Conmutación automática | Exige modo síncrono, réplica ya sincronizada y quórum del clúster |
| Modo asíncrono | Solo admite conmutación forzada, con posible pérdida de datos |
| Espera de sesión | 10 segundos por defecto, mínimo 5; por debajo se provocan falsos fallos |
| Punto de conexión | Un listener: nombre de red virtual, dirección IP virtual y puerto |
Esa fila de la espera de sesión encierra una lección general. Bajar los tiempos de detección parece mejorar la disponibilidad; sin embargo, en un sistema cargado produce lo contrario: conmutaciones provocadas por una pausa momentánea, que cuestan más caídas de las que evitan. Por consiguiente, la tolerancia a fallos se afina con medida, no bajando todos los umbrales.
Alta disponibilidad en el centro de datos
Por debajo de los servidores está la instalación física, y ahí la redundancia se mide en acometidas eléctricas, plantas, unidades de enfriamiento y rutas de distribución. El marco más citado es la clasificación en niveles del Uptime Institute.
| Nivel | Nombre | Redundancia | Qué permite |
|---|---|---|---|
| Tier I | Capacidad básica | N | Espacio dedicado, UPS, refrigeración y planta. Una sola ruta |
| Tier II | Capacidad redundante | N+1 | Componentes de repuesto, pero una sola ruta de distribución |
| Tier III | Mantenible en paralelo | N+1 con doble ruta | Mantener o sustituir cualquier componente sin parar la operación |
| Tier IV | Tolerante a fallos | 2N | Sistemas aislados físicamente; un fallo no llega a la sala |
El mito de los porcentajes por nivel
Circula por todas partes una tabla que asigna 99,671 %, 99,741 %, 99,982 % y 99,995 % a los cuatro niveles. Conviene saber que no es del Uptime Institute. La propia organización lo desmiente en su artículo sobre mitos y errores sobre el sistema de niveles: retiró toda referencia a la caída esperada por año en 2009 y aclara que esas cifras «nunca formaron parte de las definiciones de los niveles».
El motivo es sensato. Un nivel describe lo que la instalación puede sostener, no lo que va a ocurrir, porque la disponibilidad real depende también de la operación y, sobre todo, porque los modelos estadísticos no saben modelar el error humano. Si un proveedor le vende un porcentaje amparado en su nivel, está citando una tabla que su fuente desautorizó hace más de quince años.
Alta disponibilidad en la nube: zonas, regiones y SLA
En la nube la redundancia física ya está montada, y lo que se contrata es cómo repartirse sobre ella. La unidad básica es la zona de disponibilidad: un grupo de centros de datos dentro de una misma región con energía, refrigeración y red independientes.
| Dato de las zonas de Azure | Valor documentado |
|---|---|
| Zonas por región compatible | Tres |
| Separación física | Varios kilómetros, normalmente menos de 100 |
| Latencia entre zonas | Objetivo aproximado de 2 ms de ida y vuelta |
| Tráfico entre zonas | Sin cargo dentro de la misma región |
| Actualizaciones de la plataforma | Se despliegan por zonas, de una en una |
| Qué NO cubre | La caída de una región completa |
Esa última fila obliga a decidir. Un servicio repartido en tres zonas resiste la pérdida de un centro de datos, y no resiste un incidente que afecte a toda la región; para eso hace falta una segunda región, con el coste y la complejidad que eso implica. Lo mismo aplica a las caídas de servicios en la nube que se vieron en 2026.
Qué garantiza de verdad un SLA
El acuerdo de nivel de servicio no es una promesa de funcionamiento: es un compromiso condicionado con una compensación asociada. Microsoft lo explica con una claridad poco habitual y conviene citarlo de cerca.
| Lo que mucha gente asume | Lo que dice la documentación |
|---|---|
| Un 99,9 % garantiza el servicio | No garantiza disponibilidad continua, y tampoco significa esperar solo 8,7 horas de caída al año |
| El SLA es mi objetivo de fiabilidad | El SLA es el mínimo del proveedor; su objetivo propio es un SLO, que puede ser más exigente |
| Cualquier fallo cuenta | Solo cuenta lo que el documento define como caída, y hay exclusiones |
| Basta con desplegar bien | Puede exigir además reintentos, cuotas o un nivel de servicio concreto |
| El crédito compensa la pérdida | Los créditos no cubren ingresos perdidos ni daño reputacional |
Los porcentajes también dependen del despliegue. Azure compromete un 99,95 % para dos o más máquinas virtuales dentro de un conjunto de disponibilidad, y un 99,9 % para una máquina única que use discos SSD premium o superiores. Es decir, la misma nube da tres cifras distintas según cómo se coloque el mismo servidor.
Por qué no se multiplican los SLA
Aquí hay un matiz que separa a quien ha leído las fuentes de quien copia una fórmula. Amazon explica que, ante dependencias duras, la disponibilidad del conjunto es el producto de las disponibilidades: tres componentes al 99,99 % dan 99,97 %. Microsoft, en cambio, advierte de que no se debe construir un SLA compuesto multiplicando porcentajes contractuales, porque el cálculo supone que los servicios fallan de forma independiente, cosa que casi nunca ocurre, e ignora las definiciones y exclusiones de cada documento.
No se contradicen: hablan de cosas distintas. La multiplicación sirve como techo teórico al estimar el diseño de componentes propios, y no sirve como promesa contractual frente a un tercero. La regla práctica es usarla para descubrir de cuántas piezas depende usted, nunca para prometerle una cifra a un cliente.
Microsoft 365 y el software como servicio
Con un servicio en nube, la alta disponibilidad la sostiene el proveedor y el cliente hereda su nivel. Microsoft compromete un 99,9 % mensual respaldado económicamente para sus servicios en línea, y ese número describe la plataforma, no los datos que hay dentro.
La distinción vuelve a ser la de siempre. Si un buzón se vacía por un borrado, por una salida mal gestionada o por una cuenta comprometida, la plataforma sigue disponible al 99,9 % y el dato no está. Por eso la administración de Microsoft 365 incluye retención y copia, que son una capa aparte del acuerdo de disponibilidad.
Queda además la parte que sí es suya: el acceso. Si su única salida a internet se cae, su correo en la nube está disponible y usted no puede llegar a él. La disponibilidad de un servicio contratado es tan buena como el peor tramo del camino hasta él.
Cómo diseñar la alta disponibilidad, paso a paso
Un proyecto de alta disponibilidad que empieza comprando hardware casi siempre termina caro y desequilibrado. El orden que funciona parte del negocio y baja hacia la técnica.
- Liste los procesos, no los servidores. Facturar, despachar, atender al cliente, pagar la nómina. Un servidor no tiene valor propio: lo tiene el proceso que sostiene.
- Ponga cifras a cada proceso. Cuánto cuesta una hora parado y cuántos datos se pueden perder. Sin esos dos números no hay forma de justificar nada.
- Dibuje la ruta completa de una petición, desde el equipo del usuario hasta el dato, pasando por la red, el enlace y la energía.
- Marque los puntos únicos de esa ruta y ordénelos por lo que cuesta resolver cada uno.
- Empiece por lo barato. Segunda fuente en otra regleta, un segundo controlador de dominio, un enlace agregado. Suele haber cuatro o cinco medidas de coste bajo antes de necesitar un clúster.
- Diseñe la redundancia de lo que quedó: modelo N+1 o 2N, activo-pasivo o activo-activo, síncrono o asíncrono.
- Defina el quórum y el aislamiento antes de poner el clúster en producción. Nunca después.
- Instrumente todo con monitoreo y alertas, incluido el propio mecanismo de conmutación.
- Documente y ensaye. Un procedimiento que solo existe en la cabeza de alguien no es un procedimiento.
Los pasos 1 y 2 son los que más se saltan y, en cambio, los que más ahorran. Con ellos sobre la mesa, la conversación deja de ser «queremos redundancia» y pasa a ser «estos dos procesos no pueden parar más de quince minutos y estos otros aguantan un día».
Errores frecuentes al montar alta disponibilidad
| Error | Por qué falla | Qué hacer |
|---|---|---|
| Duplicar el servidor y dejar el resto igual | El punto único se mudó a la red o a la energía | Revisar la ruta completa, no un solo equipo |
| Creer que la réplica es una copia | Replica también el borrado y el cifrado | Mantener respaldo independiente e inmutable |
| Clúster de dos nodos sin testigo | Sin desempate, cualquier corte es cerebro dividido | Añadir un testigo o un tercer nodo |
| No configurar el aislamiento del nodo | Funciona hasta el día del corte de red | Configurar y probar el fencing |
| Sondas que solo miran el puerto | Mandan usuarios a un servidor enfermo | Sondear una ruta que verifique dependencias |
| Activo-activo al 70 % por nodo | Al caer uno, el otro no da abasto | Planificar cada nodo por debajo del 50 % |
| Dos proveedores por la misma canalización | Una retroexcavadora corta los dos | Exigir rutas físicas distintas por escrito |
| No probar nunca la conmutación | La primera prueba real es el incidente | Ensayar con fecha y con acta |
Cómo se prueba la alta disponibilidad
Un diseño redundante sin ensayar es una hipótesis. Por tanto, la prueba no consiste en mirar un panel verde, sino en provocar el fallo y medir qué ocurre, con alguien cronometrando y otro anotando.
- Apagar un nodo del clúster en horario acordado y medir el tiempo hasta que el servicio responde de nuevo.
- Desconectar una fuente de poder de cada servidor, una por una, y confirmar que el equipo sigue encendido.
- Bajar un enlace del agregado y comprobar que el tráfico sigue por el otro.
- Quitar el enlace del proveedor principal y verificar cuánto tarda la salida secundaria.
- Forzar la conmutación de la base de datos y revisar si alguna transacción se perdió.
- Restaurar un respaldo a un entorno aparte, porque una copia que no se ha restaurado nunca no está comprobada.
Lo que sale de ese ejercicio casi siempre sorprende. Por ejemplo, aparecen servicios que no arrancan solos, aplicaciones que no reintentan y, con frecuencia, un procedimiento con un paso que ya no existe. Es exactamente el mismo principio que convierte la continuidad operativa en un ensayo y no en un documento.
Preguntas frecuentes sobre alta disponibilidad
¿Qué diferencia hay entre alta disponibilidad y tolerancia a fallos?
La tolerancia a fallos busca que el fallo no se note en absoluto, normalmente con componentes que trabajan en paralelo y se relevan sin interrumpir nada. La alta disponibilidad, en cambio, admite una interrupción breve mientras el servicio conmuta. Por eso la tolerancia a fallos es más cara, mientras que la segunda basta para la inmensa mayoría de las empresas.
¿Cuántos nodos necesita un clúster de alta disponibilidad?
Dos bastan para conmutar, pero dos no deciden bien: hace falta un testigo que aporte el voto de desempate. Con tres nodos, en cambio, el quórum sale solo. Por eso en un clúster de alta disponibilidad se prefiere un número impar de nodos, o bien dos nodos más un testigo externo.
¿La virtualización ya da alta disponibilidad?
Ayuda mucho, porque permite reiniciar una máquina virtual en otro anfitrión en minutos, pero no basta por sí sola. Necesita al menos dos anfitriones, almacenamiento accesible desde ambos y la función de reinicio configurada. Sin eso, la virtualización de servidores concentra el riesgo en lugar de repartirlo.
¿Cuánto cuesta la alta disponibilidad?
Depende del nivel, y no sube de forma lineal. Como referencia de orden de magnitud, un modelo N+1 añade entre un 20 % y un 50 % al coste del componente, mientras que un 2N lo duplica y suma la operación que exige. El cálculo correcto compara ese gasto con lo que cuesta una hora de parada del proceso.
¿Se puede tener alta disponibilidad con un solo servidor?
No en sentido estricto, porque el servidor sigue siendo un punto único. Sí se puede reducir mucho el tiempo de recuperación con fuentes redundantes, arreglo de discos, repuestos en sitio y copias probadas. Es una opción razonable cuando el proceso tolera un par de horas de parada.
¿Qué mido para saber si tengo alta disponibilidad de verdad?
Tres cosas. El porcentaje de disponibilidad real por servicio, medido desde el punto de vista del usuario; el tiempo de conmutación verificado en el último ensayo; y la fecha de la última restauración probada. Si alguno de los tres no tiene fecha reciente, la respuesta honesta es que no lo sabe.
Qué hacer con esto
La alta disponibilidad no es un producto: es el resultado de haber mirado la ruta completa de un servicio y haber quitado, uno a uno, los puntos de los que todo dependía. Casi siempre empieza barato —una segunda fuente, un segundo controlador, un enlace de reserva— y solo después llega al clúster.
Si quiere ordenar esa conversación en su empresa, tres pasos concretos sirven de arranque: poner por escrito cuánto cuesta una hora de parada de cada proceso, dibujar la ruta de esos procesos hasta el dato, y fijar una fecha para ensayar la conmutación y la restauración. En KHARONTE acompañamos ese trabajo desde la infraestructura y el centro de datos, el monitoreo y la continuidad operativa y el respaldo, con la mesa de servicio registrando cada cambio.