RTO y RPO son los dos objetivos que definen cualquier plan de recuperación: el RTO dice cuánto tiempo puede estar detenido un sistema, y el RPO, cuántos datos se pueden perder. La diferencia entre RTO y RPO es sencilla, pero confundirlos sale caro. A continuación verá qué es RTO, qué es RPO, cómo salen del análisis de impacto al negocio, cómo calcular los que de verdad se cumplen y qué RTO y RPO da cada estrategia de respaldo.
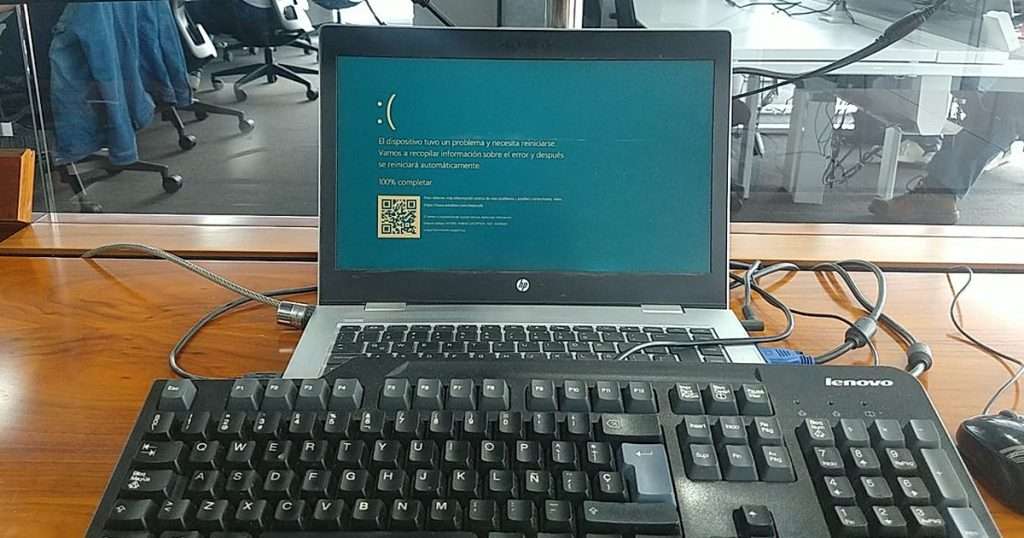
El 19 de julio de 2024, una actualización defectuosa de CrowdStrike, un programa de seguridad, dejó en pantalla azul unos 8,5 millones de equipos con Windows en todo el mundo, según el cálculo de Microsoft. Ese día, muchas empresas descubrieron en pocas horas si sus objetivos de recuperación eran una cifra medida o una frase en un contrato. Por eso esta guía no se queda en las definiciones.
Además, sirve a dos lectores. Si usted dirige una empresa o un área, le bastan los apartados de qué son, la diferencia, de dónde salen y el caso con cifras. Si administra la infraestructura, también encontrará las fórmulas, los rangos de cada estrategia según la documentación de AWS y de Microsoft, y los errores más frecuentes. El caso práctico, por su parte, continúa el de nuestra serie de Veeam: los mismos siete servidores, las mismas copias y los mismos tiempos de restauración.
¿Qué son el RTO y el RPO?
RTO y RPO son siglas en inglés. La primera es Recovery Time Objective, es decir, objetivo de tiempo de recuperación. La segunda es Recovery Point Objective, objetivo de punto de recuperación. Las dos son objetivos: metas que la empresa fija antes de un incidente, no medidas de lo que pasó después. Sus definiciones más citadas son las de la guía SP 800-34 del NIST, el instituto de normas de Estados Unidos.
Qué es RTO: cuánto tiempo puede estar detenido un sistema
El RTO es el tiempo máximo que un sistema puede pasar en recuperación antes de afectar de forma seria a la operación. En concreto, el NIST lo define como el lapso total que los componentes de un sistema pueden estar en fase de recuperación sin perjudicar la misión de la organización. Se mide en minutos, horas o días. Además, el reloj empieza con la interrupción, no cuando alguien la nota.
Por ejemplo, si el RTO del sistema de facturación es de dos horas, la empresa acepta estar sin facturar hasta dos horas. Por lo tanto, todo lo que hace falta para volver, desde detectar la falla hasta comprobar que el sistema funciona, tiene que caber en ese plazo.
Qué es RPO: cuántos datos se pueden perder
El RPO es el punto en el tiempo al que deben recuperarse los datos después de una interrupción, según la definición del NIST. En la práctica se expresa como una cantidad de tiempo. Así, un RPO de cuatro horas significa que, tras la falla, la empresa acepta volver a como estaba hace cuatro horas como máximo. Es decir, acepta perder hasta cuatro horas de trabajo.
Por eso el RPO mira hacia atrás y decide cada cuánto hay que copiar o replicar los datos. Si las copias se hacen una vez al día, el RPO no puede ser menor de un día, diga lo que diga el documento.
RTO y RPO explicados sin tecnicismos
Piense en un documento de Word. Si el programa guarda una copia cada diez minutos y se va la luz, usted pierde como mucho diez minutos de trabajo: ese es su RPO. En cambio, si el computador se daña y conseguir otro le toma dos horas, ese es su RTO. Esa es toda la diferencia entre RTO y RPO: son dos preguntas distintas, y una empresa necesita responder las dos para cada sistema. Es decir, cuánto puedo perder y cuánto puedo esperar.
Diferencia entre RTO y RPO
La diferencia entre RTO y RPO está en lo que mide cada uno. El RTO cuenta el tiempo hacia adelante, desde la interrupción hasta que el servicio vuelve. El RPO, en cambio, cuenta hacia atrás, desde la interrupción hasta el último dato a salvo. La tabla resume la diferencia entre RTO y RPO punto por punto:
| Aspecto | RTO | RPO |
|---|---|---|
| Pregunta que responde | ¿Cuánto tiempo puedo estar detenido? | ¿Cuántos datos puedo perder? |
| Sentido | Hacia adelante, después de la falla | Hacia atrás, antes de la falla |
| Se mide en | Tiempo sin servicio | Tiempo de trabajo perdido |
| Lo determina | La velocidad para detectar, restaurar y verificar | La frecuencia de las copias o de la réplica |
| Cómo se reduce | Con restauración más rápida, equipos de reserva o alta disponibilidad | Con copias más frecuentes o réplica continua |
| Qué cuesta reducirlo | Infraestructura duplicada y personal disponible | Más almacenamiento, red y licencias |
| Ejemplo | Volver a facturar en dos horas | Perder como máximo cuatro horas de facturas |
Además, la diferencia entre RTO y RPO no es solo de definición: son independientes. Un sistema puede tener un RTO corto y un RPO largo, como un sitio web informativo que debe volver pronto aunque su contenido cambie poco. O al revés: un archivo histórico puede esperar un día, pero no puede perder ni un documento. Por eso se fijan por separado y sistema por sistema.
MTD, MTPD y WRT: los otros tiempos del plan
Junto al RTO y al RPO aparecen otras siglas, y conviene ubicarlas antes de seguir:
| Sigla | Qué significa | Qué dice |
|---|---|---|
| MTD | Tiempo máximo tolerable de inactividad | Cuánto puede interrumpirse un proceso sin causar un daño serio; así lo define el NIST |
| MTPD | Periodo máximo tolerable de interrupción | Es el mismo límite, con el nombre habitual en las normas ISO de continuidad de negocio |
| RTO | Objetivo de tiempo de recuperación | El plazo para recuperar el sistema; por eso tiene que ser menor que el MTD |
| WRT | Tiempo de recuperación del trabajo | Lo que tardan las personas en ponerse al día después: comprobar datos y volver a ingresar lo perdido |
| RPO | Objetivo de punto de recuperación | Hasta qué momento se vuelve con los datos |
| RTA y RPA | Tiempo y punto de recuperación reales | Lo que de verdad se logró en una prueba o en un incidente |
La relación entre ellas es simple: el RTO más el tiempo de ponerse al día no puede pasar del MTD, que sale del análisis de impacto al negocio. Por eso el RTO se fija con margen. Además, la última fila es la que separa un plan de un deseo, porque un objetivo que nunca se ha medido en una prueba es solo una intención.
De dónde salen: el análisis de impacto al negocio
El RTO y el RPO no los decide el área de TI. Salen del análisis de impacto al negocio, o BIA por sus siglas en inglés, que pregunta a cada área qué pasa si su proceso se detiene. Con esas respuestas, la dirección fija cuánto está dispuesta a perder. Después, TI traduce ese límite en copias, réplicas y equipos. Un análisis de impacto al negocio sencillo sigue estos pasos:
- Listar los procesos: por ejemplo, facturar, despachar, pagar la nómina y atender clientes.
- Estimar el impacto de cada hora detenida: es decir, ventas que no se hacen, personas sin trabajar, sanciones o clientes molestos.
- Fijar el MTD: o sea, a partir de qué momento el daño es inaceptable.
- Identificar los sistemas de los que depende cada proceso.
- Derivar el RTO de cada sistema, siempre por debajo del MTD del proceso.
- Preguntar por los datos: cuánto trabajo se puede rehacer a mano. De ahí sale el RPO.
- Agrupar por niveles, para no diseñar después una solución distinta por sistema.
Cuánto cuesta una hora detenida
El segundo paso del análisis de impacto al negocio es el que más discusión genera, así que conviene tener una fórmula. El costo de una hora detenida suma tres partes. Primero, las personas que no pueden trabajar, multiplicadas por lo que cuesta su hora. Segundo, las ventas que no se hacen o se retrasan. Y tercero, lo que cuesta ponerse al día después, que incluye las horas extra y los datos que hay que volver a ingresar.
No hace falta una cifra exacta. De hecho, basta un orden de magnitud por proceso para comparar: si una hora sin facturar cuesta diez veces más que una hora sin la intranet, sus objetivos no pueden ser los mismos.
Ejemplos de RTO y RPO por niveles
El resultado suele ser una tabla de tres o cuatro niveles. Los valores de esta son de ejemplo; cada empresa llega a los suyos con su propio análisis de impacto al negocio:
| Nivel | Sistemas típicos | RTO | RPO |
|---|---|---|---|
| Crítico | ERP, facturación y correo | De 1 a 4 horas | De minutos a 4 horas |
| Importante | Archivos compartidos e intranet | De 4 a 24 horas | 24 horas |
| Diferible | Pruebas y archivo histórico | Varios días | Una semana |
Como advierte la guía de arquitectura de AWS, conviene no elegir una estrategia más exigente de lo necesario, porque cada escalón cuesta más. En otras palabras, pedir «cero pérdida y cero parada» para todo es la forma más cara de no decidir.
Cómo calcular el RTO y el RPO que de verdad se cumplen
Una cosa es el objetivo y otra lo que la infraestructura logra. Por eso, para saber si un RTO y un RPO se cumplen, hay que calcular el valor logrado en el peor caso y compararlo con el objetivo. Aquí la diferencia entre RTO y RPO vuelve a notarse, porque cada uno se calcula con una cuenta distinta.
El RPO logrado: intervalo más duración
El peor caso de pérdida de datos no es el intervalo entre copias. Es el intervalo más lo que tarda la copia en terminar y, si el escenario lo exige, en salir de la sede. Por ejemplo, con una copia diaria a las 22:00 que termina a las 22:04, una falla a las 22:03 del día siguiente devuelve a la empresa a la noche anterior. Es decir, el RPO logrado es de 24 horas y 4 minutos.
Además, conviene medirlo en horas de trabajo y no solo de reloj. Si nadie trabaja de noche, perder de las 22:00 a las 08:00 no cuesta nada. En cambio, perder de las 08:00 a las 18:00 cuesta la jornada entera.
El RTO logrado: cuatro tiempos, no uno
El RTO logrado tampoco es el tiempo de restauración. En realidad, es la suma de cuatro tiempos:
- Detección: desde la falla hasta que alguien lo sabe. Por eso un buen monitoreo de servidores la reduce a minutos.
- Diagnóstico y decisión: entender qué pasó y, después, decidir que se restaura.
- Restauración: copiar los datos de vuelta. Se estima dividiendo los datos entre la velocidad.
- Verificación: arrancar, comprobar los datos y, por último, validar con un usuario antes de reabrir.
La restauración se calcula con una división. Por ejemplo, 214 GiB a 110 MB/s son unos 33 minutos. Sin embargo, los otros tres tiempos dependen de personas y casi nunca se escriben, así que son los que más sorprenden el día del incidente.
Qué RTO y RPO da cada estrategia
Cada forma de proteger un sistema ofrece un rango de objetivos. La guía de buenas prácticas de AWS ordena cuatro estrategias de menor a mayor costo y complejidad y, a la vez, de mayor a menor RTO y RPO. Aunque habla de su nube, los rangos sirven de referencia para cualquier entorno:
| Estrategia | Cómo funciona | RPO | RTO |
|---|---|---|---|
| Copia y restauración | Los datos se copian a otro sitio y se restauran cuando hace falta | Horas | 24 horas o menos |
| Luz piloto (pilot light) | Los datos se replican y la infraestructura mínima espera apagada | Minutos | Decenas de minutos |
| Espera activa (warm standby) | Una copia reducida del sistema está siempre encendida | Segundos | Minutos |
| Activo-activo en varios sitios | El sistema atiende desde dos sitios a la vez | Casi cero | Puede ser cero |
La réplica no sustituye a la copia
La misma guía repite una advertencia: la réplica continua protege de algunos desastres, pero no de la corrupción ni del borrado de datos, salvo que además existan puntos a los que volver. La razón es simple, porque una réplica copia también el error. Si alguien borra una tabla o un programa malicioso cifra los archivos, la réplica lo refleja en segundos.
Por lo tanto, un RPO de segundos frente a la falla de un equipo puede ser un RPO de un día frente a un borrado, ya que entonces depende de la última copia. Del mismo modo, la alta disponibilidad reduce el RTO cuando falla un servidor, pero no devuelve un archivo borrado.
Ejemplos de frecuencias reales
Algunos datos de la documentación de Microsoft ayudan a aterrizar los rangos. Por un lado, Azure Site Recovery replica de forma continua las máquinas de Azure y, en Hyper-V, con una frecuencia de hasta 30 segundos. Por otro, Azure Backup con la directiva mejorada copia como mucho cada 4 horas, así que su RPO mínimo es de 4 horas. En un entorno propio, en cambio, las copias se programan con el intervalo que pida el plan, como muestra el caso.
En la nube, el RPO sigue siendo suyo
Tener los datos en un servicio en la nube no fija por sí solo el RTO y el RPO. El proveedor responde por la disponibilidad de su plataforma, pero no por un archivo que alguien borró hace dos meses. Por ejemplo, en Microsoft 365 un correo eliminado se puede recuperar durante 14 días por defecto, y un archivo, durante 93. Pasado ese plazo, sin una copia aparte ya no hay punto al que volver, como detalla nuestra guía de backup de Microsoft 365. Por lo tanto, el análisis de impacto al negocio también tiene que incluir los sistemas que la empresa no aloja.
Un caso: los RTO y RPO de siete servidores
Tome la empresa de 120 personas de la serie de Veeam, con sus siete máquinas virtuales protegidas. Lo que sigue usa lo que aquellas guías ya fijaron. Primero, dos trabajos de copia: uno diario a las 22:00 para las siete máquinas y otro para el ERP a las 08:00, 12:00, 16:00 y 20:00. Segundo, una copia a la nube detrás del trabajo diario. Y tercero, restauraciones a unos 110 MB/s. Los datos son de ejemplo, pero las cuentas son exactas.
Los supuestos nuevos son tres: la empresa trabaja de 08:00 a 18:00, 45 personas dependen del ERP y la dirección aprobó, tras su análisis de impacto al negocio, estos objetivos de RTO y RPO:
| Sistema | Si se detiene | RTO objetivo | RPO objetivo |
|---|---|---|---|
| ERP (erp-db y erp-app) | No se factura ni se despacha | 2 horas | 4 horas |
| Archivos (file-01) | Las áreas siguen con lo que tienen abierto | 4 horas | 24 horas |
| Web (web-01 y web-02) | Uno de los dos sigue atendiendo | 4 horas | 24 horas |
| Directorio (dc-01 y dc-02) | El otro sigue autenticando | 8 horas | 24 horas |
Primer hallazgo: el plan tiene dos RPO
El RPO depende del escenario. Si falla un servidor y el repositorio de la sede está intacto, el ERP vuelve al último de sus cinco puntos del día. En cambio, si se pierde la sede, por un incendio o un robo, solo queda la nube, y la nube solo recibe el trabajo diario:
| Escenario | Punto más reciente del ERP | Trabajo perdido en el peor caso |
|---|---|---|
| Falla un servidor | La última corrida: 08:00, 12:00, 16:00, 20:00 o 22:00 | 4 horas de trabajo |
| Se pierde la sede | El punto diario de las 22:00, que está en la nube a las 22:29 | 10 horas de trabajo, es decir, la jornada entera |
Es decir, el objetivo de 4 horas se cumple en el primer escenario y se incumple en el segundo, donde el peor caso de reloj llega a 24 horas y 29 minutos. Sin embargo, el arreglo es barato: copiar también a la nube la cadena del ERP. Cada corrida pesa unos 2,4 GiB y sube en 4 minutos, y la cadena de una semana ocupa 271 GiB más.
Segundo hallazgo: restaurar es el 40 % del RTO
Según la guía de restauración de la serie, el ERP se restaura completo en 43 minutos. Sin embargo, el RTO logrado suma los otros tres tiempos. Con supuestos razonables para una empresa con monitoreo y un técnico disponible, la cuenta es esta:
| Paso | Minutos |
|---|---|
| Detección: salta la alerta y alguien la confirma | 10 |
| Diagnóstico y decisión de restaurar | 30 |
| Restauración completa de erp-db y erp-app | 43 |
| Arranque, comprobación de la base y validación con un usuario | 25 |
| Total | 108 |
En total, 1 hora y 48 minutos: el objetivo de 2 horas se cumple con 12 minutos de margen, y restaurar es apenas el 40 % del tiempo. Por lo tanto, quien hubiera prometido «una hora» porque la restauración tarda 43 minutos habría incumplido por 48. Con el mismo criterio, file-01 vuelve en 2 horas y 29 minutos, dentro de sus 4 horas.
Además, si se pierde la sede, la cuenta cambia de escala. Bajar de la nube los 138 GiB comprimidos del ERP por el enlace de 100 Mbit/s toma unas 4,1 horas, y bajar las siete máquinas, 13,5 horas. Y eso, siempre que exista un equipo o una nube donde restaurar. Por eso el RTO, igual que el RPO, se escribe por escenario.
Tercer hallazgo: aquí pesa más el RPO que el RTO
¿Dónde conviene invertir? La diferencia entre RTO y RPO deja de ser teórica cuando se cuenta en horas-persona. Con el ERP detenido 108 minutos, 45 personas pierden 81 horas-persona. En cambio, si se pierden 4 horas de datos, esas mismas personas tienen que rehacer hasta 180. Estas son tres mejoras posibles y lo que ahorra cada una:
| Mejora | Qué cambia | Ahorro por incidente en el peor caso |
|---|---|---|
| Copias del ERP cada hora | El RPO pasa de 4 horas a 1 hora | Hasta 135 horas-persona |
| Detección y decisión más rápidas | El RTO pasa de 108 a 60 minutos | 36 horas-persona |
| Cadena del ERP también en la nube | Ante la pérdida de la sede, el RPO pasa de la jornada entera a 4 horas | Hasta 270 horas-persona |
La primera mejora casi no cuesta espacio, porque el ERP cambia unos 9,5 GiB comprimidos al día, se repartan en 4 corridas o en 13. Lo que crece es el número de puntos, de 28 a 91 por semana. En resumen, en este caso rinde más acortar el RPO que acelerar la restauración, justo lo contrario de lo que suele discutirse.
Qué enseña el caso
Primero, un objetivo sin escenario está incompleto: el mismo ERP tiene un RPO de 4 horas ante una falla y de un día ante la pérdida de la sede. Segundo, el RTO se suma paso a paso y no se deduce de la velocidad del disco. Tercero, las cuentas se hacen en horas de trabajo y en personas, que es el idioma en que decide la dirección. Y cuarto, la diferencia entre RTO y RPO importa a la hora de invertir, porque aquí rinde más el segundo.
Cómo se comprueban el RTO y el RPO
Un RTO solo es creíble si alguien lo midió. Por eso el plan incluye pruebas periódicas: se restaura una máquina en una red aislada, se toma el tiempo de cada paso y se anota el resultado. Si supera el objetivo, se cambia la solución o se cambia el objetivo, pero no se deja la diferencia sin escribir.
En el caso, el plan trimestral prueba las siete máquinas, dos o tres por mes, como explica la guía de verificación de las copias. Además, conviene repetir el análisis de impacto al negocio cuando cambia la operación, porque un sistema que ayer era secundario puede volverse crítico con un cliente nuevo.
RTO y RPO en el contrato
Cuando el servicio lo presta un tercero, el RTO y el RPO deben quedar en el contrato, junto con el alcance: qué sistemas cubre, en qué escenarios, en qué horario se atiende y cómo se informa el resultado de las pruebas. De lo contrario, cada parte recordará una cifra distinta el día del incidente.
Errores frecuentes con el RTO y el RPO
- Confundirlos. La diferencia entre RTO y RPO no es un matiz: un RTO de 4 horas no dice nada sobre los datos perdidos.
- Fijarlos sin el negocio. Sin un análisis de impacto al negocio, TI tiene que adivinar cuánto vale una hora de facturación.
- Pedir cero en todo. Es la opción más cara y, además, casi nunca la necesaria.
- Tomar el intervalo por el RPO. Falta sumar lo que tarda la copia y, después, su salida de la sede.
- Tomar la restauración por el RTO. Faltan detectar, decidir y verificar.
- Olvidar el escenario. La falla de un servidor y la pérdida de la sede dan cifras distintas.
- Confiar en la réplica como copia. Sin embargo, la réplica también copia el borrado.
- No probar. Por consiguiente, el objetivo se queda en una intención.
Preguntas frecuentes sobre RTO y RPO
¿Qué es RTO en pocas palabras?
El RTO es el tiempo máximo que un sistema puede estar detenido tras una falla antes de causar un daño inaceptable.
¿Qué es RPO en pocas palabras?
El RPO es la cantidad máxima de datos, medida en tiempo, que la empresa acepta perder. Es decir, la distancia entre la falla y la última copia utilizable.
¿Cuál es la diferencia entre RTO y RPO?
La diferencia entre RTO y RPO es lo que mide cada uno: el RTO, el tiempo sin servicio, y el RPO, los datos que se pierden. Por eso el primero se mejora restaurando más rápido, y el segundo, copiando más seguido.
¿Qué es el análisis de impacto al negocio?
El análisis de impacto al negocio, o BIA, es el estudio que estima cuánto daño causa la interrupción de cada proceso y a partir de qué momento ese daño es inaceptable. De él salen el MTD, el RTO y el RPO de cada sistema.
¿Puede el RPO ser cero?
Solo con réplica síncrona, en la que cada dato se escribe en dos sitios antes de darse por guardado. Es costosa y, aun así, no protege de un borrado, así que siguen haciendo falta copias.
¿Cuál es más importante, el RTO o el RPO?
Depende del sistema. En uno que registra transacciones suele pesar más el RPO, porque los datos perdidos hay que rehacerlos. En cambio, en uno que solo muestra información pesa más el RTO.
¿Quién define el RTO y el RPO?
La dirección y las áreas dueñas de cada proceso, con el análisis de impacto al negocio. TI, por su parte, aporta lo que cuesta cada opción y comprueba que el RTO y el RPO se cumplan.
¿Cada cuánto se revisan?
Al menos una vez al año y, además, cada vez que cambia algo importante: un sistema nuevo, una sede nueva o un contrato que exige más. En cada revisión se actualiza también el análisis de impacto al negocio.
¿Qué diferencia hay entre RTO y SLA?
El RTO es un objetivo interno de recuperación de un sistema. El SLA, en cambio, es el compromiso que un proveedor firma con su cliente, y puede incluir el RTO y el RPO entre sus cláusulas.
Cómo lo aborda KHARONTE
En KHARONTE, los objetivos no se quedan en un documento. Dentro de nuestra línea de continuidad operativa y respaldo diseñamos, implementamos y administramos Veeam Backup, con esquemas de respaldo local, en NAS y en nube, pruebas periódicas de restauración y un plan de recuperación ante desastres con RTO y RPO definidos para cada sistema. Si quiere ver el alcance completo, esta es nuestra página de backup para empresas.
Además, cada copia fallida y cada solicitud de restauración entra como caso en nuestra mesa de ayuda TI y se atiende según su criticidad. Y si busca servicios administrados de TI que reúnan el respaldo, el monitoreo y el soporte, conozca el resto de nuestros servicios de TI para empresas.